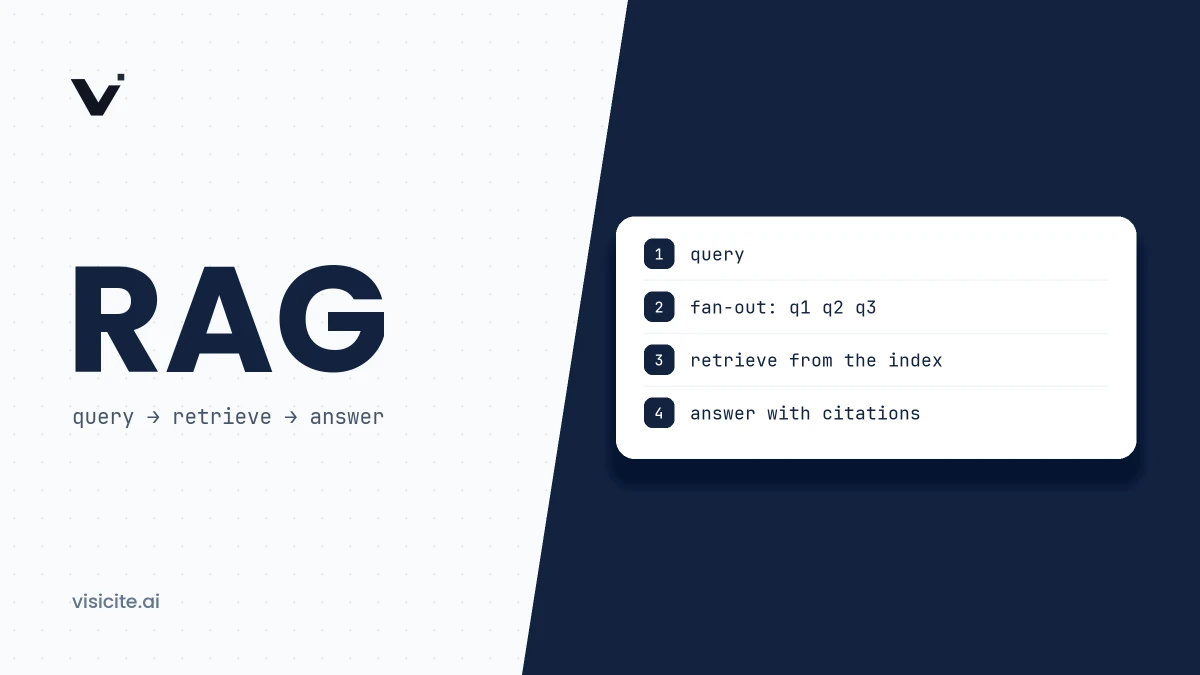

En AI-sökmotor svarar inte ur minnet. Den skriver om din fråga till en eller flera sökfrågor, hämtar sidor ur ett sökindex, väljer ut de textstycken som passar bäst och låter en språkmodell formulera ett svar utifrån dem, med länkar till källorna. Tekniken kallas retrieval-augmented generation (RAG), eller grounding. Därför avgörs din synlighet i AI-svar främst av om du finns i rätt index och om enskilda stycken på din sida går att förstå och citera var för sig.
I korthet
- En språkmodell har två kunskapskällor: det den lärde sig under träningen och det den hämtar från webben i stunden. Källhänvisningar kommer nästan alltid från det senare.
- Frågan skrivs om och delas ofta upp i flera sökningar. Google kallar det query fan-out.
- Det är stycken, inte hela sidor, som väljs ut och citeras.
- Varje leverantör har olika robotar för träning, sökindex och användarstyrda hämtningar. Du kan säga nej till träning och ändå synas i svaren.
- Ingen leverantör publicerar sina rankningsvikter. Det som är dokumenterat är grundkraven: åtkomst, indexering och läsbar text.
Två kunskapskällor: träningsdata och hämtning i realtid
En språkmodell tränas på en stor textmängd fram till ett visst datum. Det den lärt sig ligger sedan lagrat i modellens parametrar. Den kunskapen är bred men har tre svagheter: den blir gammal, den går inte att uppdatera utan ny träning och modellen kan inte peka ut var en uppgift kommer ifrån.
Lösningen beskrevs 2020 i forskningsartikeln Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks av Patrick Lewis med flera. Författarna kombinerade modellens inbyggda, "parametriska" minne med ett externt, sökbart minne och pekade ut just proveniens och uppdatering av kunskap som olösta problem för rena språkmodeller. Dagens AI-sökmotorer bygger på samma idé, fast det externa minnet är ett index över webben.
För dig som sajtägare är skillnaden praktisk:
| Träningsdata | Hämtning i realtid | |
|---|---|---|
| När läses din sida? | Vid insamling inför träning, månader eller år före svaret | När indexet byggs och ibland i samma stund som frågan ställs |
| Får du en länk? | Normalt inte | Ja, källan visas i svaret |
| Hur snabbt slår en ändring igenom? | Först vid nästa modellversion | När sidan har crawlats om |
| Vilken robot styr du? | Träningsrobotar som GPTBot och ClaudeBot | Sökrobotar som OAI-SearchBot, PerplexityBot, Googlebot och bingbot |
Hur modeller värderar källor, både i träningen och vid hämtning, går vi igenom i artikeln om hur stora språkmodeller väljer sina källor. Här håller vi oss till mekaniken.
Från fråga till svar i fem steg
1. Systemet avgör om det behöver söka
Alla frågor leder inte till en sökning. Anthropic beskriver det tydligast: Claude söker när frågan gäller sådant som är aktuellt, föränderligt eller ligger utanför träningsdatan, till exempel nyheter, priser eller uppgifter om en viss organisation, och svarar direkt när det gäller stabil kunskap, enligt dokumentationen för Claudes webbsökverktyg. Google skriver på motsvarande sätt att AI Overviews bara visas när systemen bedömer att de tillför något utöver vanliga sökresultat.
2. Frågan skrivs om och delas upp
Det du skriver är sällan det som skickas till sökindexet. Tre leverantörer säger det rakt ut:
- Google: AI Overviews och AI Mode kan använda query fan-out, det vill säga flera relaterade sökningar över delämnen och datakällor, vilket gör att de kan visa en bredare uppsättning länkar än en vanlig sökning. Det står i Googles dokumentation om AI-funktioner.
- OpenAI: när ChatGPT-sök använder externa sökleverantörer skrivs frågan normalt om till en eller flera riktade sökfrågor, enligt OpenAI:s hjälpartikel om webbsökning.
- Microsoft: Copilot Chat skickar sökfrågor "bestående av några få ord" som genererats ur prompten till Bing. Microsofts eget exempel: en prompt om ett möjligt förvärv av företaget Fabrikam blir sökfrågorna
Fabrikam strategyochFabrikam financials. Exemplet finns i Microsofts dokumentation för Copilot Chat.
Anthropic anger att en enkel faktafråga brukar kräva 1 till 3 sökningar medan jämförelser och frågor om flera aktörer kan kräva 10 eller fler. Slutsatsen för dig: du konkurrerar inte om en enda sökfras. En sida som tydligt besvarar en avgränsad delfråga kan hämtas in i ett svar på en mycket bredare fråga.
3. Kandidater hämtas ur ett index
Sökfrågorna körs mot ett index som byggts i förväg av en crawler. Google använder sitt sökindex, Copilot använder Bing, och Perplexity har ett eget index som enligt företagets tekniska beskrivning från september 2025 då omfattade över 200 miljarder unika URL:er. Finns din sida inte i indexet kan den inte bli en kandidat, hur bra den än är.
4. Stycken väljs ut
Modellen kan inte läsa allt. Systemet måste krympa träffarna till de textavsnitt som faktiskt besvarar frågan. Perplexity är den leverantör som beskriver steget mest öppet: dokumenten delas upp i fristående avsnitt som hämtas och rangordnas vart och ett för sig, sökningen kombinerar ordmatchning med semantisk sökning, och rangordningen sker i flera steg där snabba modeller sållar först och tyngre omrankningsmodeller avgör slutresultatet. Anthropic beskriver en annan variant: i nyare versioner av sökverktyget skriver Claude kod som filtrerar sökresultaten innan de når modellen, så att bara relevant innehåll kommer med.
Google, OpenAI och Microsoft redovisar inte motsvarande detaljer. Men principen att stycken bedöms var för sig förklarar varför fristående text fungerar bättre än text som lutar sig mot sitt sammanhang:
Svårt att lyfta ut: "Som vi nämnde ovan gäller det även här, men med den skillnaden att tiden är kortare."
Lätt att lyfta ut: "Ångerrätten vid distansköp är 14 dagar och räknas från den dag du tar emot varan."
Det andra stycket går att förstå utan resten av sidan. Mer om hantverket finns i guiden om att skriva innehåll som AI vill citera.
5. Svaret skrivs och källorna fästs
De utvalda styckena läggs in i modellens kontext tillsammans med frågan, och modellen skriver svaret utifrån dem. Källhänvisningen knyts till det stycke som stöder ett visst påstående. I Claudes API syns det konkret: varje hänvisning innehåller källans URL, titel och upp till 150 tecken av den citerade texten, och hänvisningar är alltid påslagna för webbsökning. Perplexity uppger att varje svar har numrerade hänvisningar som länkar till originalkällorna. Copilot Chat visar dessutom exakt vilka sökfrågor som skickades till Bing.
En källhänvisning är ingen garanti för att påståendet stämmer. Modellen kan sammanfatta en källa fel eller dra en slutsats som källan inte stöder. Klicka dig fram till originalet när uppgiften är viktig.
Så skiljer sig produkterna åt
Tabellen sammanfattar vad leverantörerna själva dokumenterar, per november 2026.
| Produkt | Varifrån hämtas sidorna? | Vad är dokumenterat om frågor och citat? |
|---|---|---|
| ChatGPT-sök | OpenAI:s egen crawler OAI-SearchBot och, ibland, externa sökleverantörer | Frågan skrivs om till en eller flera riktade sökfrågor när externa leverantörer används |
| Google AI Overviews och AI Mode | Googles sökindex | Query fan-out. Svaren visas med länkar till stödjande sidor |
| Perplexity | Eget index, där PerplexityBot crawlar sidorna | Hybridsökning, rangordning på styckenivå, numrerade källor i varje svar |
| Microsoft Copilot | Bings söktjänst | Korta genererade sökfrågor. Copilot Chat visar sökfrågorna bredvid källorna |
| Claude med webbsök | Ett sökverktyg vars leverantör inte namnges i verktygets dokumentation. Anthropic har också en egen sökcrawler, Claude-SearchBot | Claude avgör själv när sökning behövs och kan söka flera gånger. Citat med URL, titel och citerad text |
ChatGPT-sök
OpenAI har fyra dokumenterade robotar. OAI-SearchBot används för att lyfta fram webbplatser i ChatGPT:s sökfunktioner. GPTBot samlar in innehåll som kan användas för att träna OpenAI:s modeller. ChatGPT-User gör hämtningar som en användare har satt igång, och OpenAI skriver att robots.txt-regler då "kanske inte gäller" samt att ChatGPT-User inte avgör om innehåll får visas i sök. OAI-AdsBot kontrollerar sidor som skickats in som annonser. En ändring i robots.txt kan ta omkring 24 timmar att slå igenom för sök. Allt står i OpenAI:s översikt över crawlers. Vilka externa sökleverantörer som används i ett enskilt svar framgår inte av hjälpartikeln.
Google AI Overviews och AI Mode
Google är ovanligt tydligt: för att kunna visas som länk i AI Overviews eller AI Mode ska sidan vara indexerad och kunna visas med ett utdrag i vanlig sökning. Enligt Google finns inga ytterligare krav, och du behöver varken nya maskinläsbara filer, särskilda AI-textfiler eller särskild schema.org-märkning. Du begränsar användningen med samma verktyg som för utdrag: nosnippet, data-nosnippet, max-snippet och noindex.
Ett vanligt missförstånd gäller Google-Extended. Det är en token i robots.txt utan egen user agent, som styr om ditt innehåll får användas för att träna framtida Gemini-modeller och för grounding i Gemini-apparna och Vertex AI. Den påverkar inte om du finns med i Google Sök och är ingen rankningssignal, enligt Googles lista över crawlers.
Perplexity
Perplexity söker på webben för varje fråga och bygger sitt eget index. PerplexityBot indexerar sidor för sökresultaten och respekterar robots.txt. Perplexity-User hämtar en sida när en användares fråga kräver det och bortser enligt Perplexitys crawlerdokumentation i regel från robots.txt, eftersom hämtningen är användarstyrd. Ingen av dem används för att träna grundmodeller. Detaljerna finns i vår genomgång av hur Perplexity fungerar.
Microsoft Copilot
Copilot förankrar sina svar i Bings söktjänst, och Bings crawler heter bingbot. Sedan februari 2026 finns rapporten AI Performance i Bing Webmaster Tools, som visar hur ofta dina sidor citeras i Microsoft Copilot, i AI-sammanfattningar i Bing och hos utvalda partner, samt vilka "grounding queries" som användes när innehållet hämtades. Microsoft kallar siffrorna ett urval, och rapporten visar citeringar, inte klick. Läs mer i Bings lansering av AI Performance.
För att begränsa användningen införde Bing 2023 två metataggar för det som då hette Bing Chat: NOCACHE gör att bara URL, titel och utdrag får användas, och NOARCHIVE utesluter sidan helt ur svaren och ur träningen av Microsofts generativa modeller. Beskrivningen finns i Bings blogginlägg från september 2023.
Claude med webbsök
Anthropic har tre robotar. ClaudeBot samlar in innehåll som kan användas för träning. Claude-SearchBot crawlar för att förbättra sökresultatens kvalitet. Claude-User hämtar sidor när en användare ställer en fråga som kräver det. Anthropic uppger att robotarna följer robots.txt och stöder tillägget Crawl-delay, och avråder från att blockera via IP-adress eftersom robotarna då inte kan läsa din robots.txt. Se Anthropics hjälpartikel om crawlers.
Vilken robot gör vad
| Leverantör | Sökindex | Användarstyrd hämtning | Träning |
|---|---|---|---|
| OpenAI | OAI-SearchBot | ChatGPT-User | GPTBot |
| Anthropic | Claude-SearchBot | Claude-User | ClaudeBot |
| Perplexity | PerplexityBot | Perplexity-User | Ingen. Enligt Perplexity används ingen av robotarna för att träna grundmodeller |
| Googlebot | Tas inte upp här | Google-Extended (token i robots.txt, ingen egen user agent) | |
| Microsoft | bingbot | Tas inte upp här | Styrs med metataggarna NOCACHE och NOARCHIVE |
Uppdelningen gör att du kan tacka nej till träning och ändå synas i svaren. Så här ser en robots.txt ut som gör det:
# Sök och användarstyrda hämtningar: tillåt
User-agent: OAI-SearchBot
User-agent: ChatGPT-User
User-agent: Claude-SearchBot
User-agent: Claude-User
User-agent: PerplexityBot
User-agent: Googlebot
User-agent: bingbot
Allow: /

# Träning: neka
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: Google-Extended
Disallow: /

Sitemap: https://www.example.se/sitemap.xml
Om du vill tillåta träning är ditt eget beslut. Poängen är att beslutet inte behöver påverka sökbarheten. Fler varianter finns i guiden om robots.txt för AI-crawlers.
Det leverantörerna inte berättar
- Rankningsvikterna. Ingen leverantör publicerar hur relevans, auktoritet och aktualitet vägs mot varandra när stycken väljs.
- Antalet källor. Hur många sidor som hämtas och hur många som slutligen citeras varierar och redovisas inte.
- Externa index. OpenAI säger att externa sökleverantörer används ibland, inte när. Dokumentationen för Claudes sökverktyg namnger ingen leverantör.
- Stabiliteten. Samma fråga kan ge olika källor vid olika tillfällen. En enstaka kontroll säger därför lite.
Den som påstår sig veta exakt varför en viss sida citeras gissar alltså. Det som går att göra är att uppfylla de dokumenterade grundkraven och mäta över tid.
Vad det betyder för din sajt
- Släpp in sökrobotarna. Kontrollera robots.txt, brandvägg och CDN. En blockerad sökrobot betyder att sidan inte finns i det indexet.
- Finns i både Google och Bing. Deras index ligger bakom AI Overviews, AI Mode och Copilot. Verifiera sajten i Search Console och Bing Webmaster Tools och skicka in din sitemap.
- Leverera innehållet som text i HTML. Google rekommenderar att viktigt innehåll finns i textform. Se de tekniska faktorerna för AI-synlighet.
- Skriv fristående stycken. Ett stycke, en poäng, med ämnet utskrivet i stället för "det" och "detta".
- Håll strukturerad data i linje med den synliga texten. Det är Googles uttryckliga råd. Se guiden om JSON-LD och strukturerad data.
- Mät. Google räknar in trafik från AI Overviews och AI Mode i Search Consoles prestandarapport under söktypen Webb. Bing har AI Performance. Metoder för övriga motorer finns i artikeln om att mäta GEO-resultat.
Vill du se hur din egen sida klarar grundkraven kan du köra Visicites kostnadsfria GEO-skanning. Den kontrollerar bland annat om AI-robotarna släpps in i robots.txt och hur beroende sidan är av JavaScript.
Vanliga frågor
Hur fungerar AI-citeringar?
När en AI-sökmotor har hämtat sidor väljer den ut de stycken som bäst besvarar frågan och lägger in dem i modellens kontext. Modellen skriver svaret utifrån styckena, och varje påstående kopplas till det stycke det bygger på. Länken du ser i svaret pekar på sidan som stycket kom från. Citeringen kommer alltså från hämtningen i realtid, inte från modellens träningsdata.
Hur optimerar man en hemsida för AI-sökmotorer som ChatGPT och Perplexity?
Börja med åtkomsten: tillåt OAI-SearchBot och PerplexityBot i robots.txt och se till att brandväggen inte stoppar dem. Se sedan till att innehållet finns som text i HTML, att varje stycke går att förstå för sig och att sidan besvarar konkreta frågor med konkreta uppgifter. Ingen åtgärd garanterar en citering, men utan åtkomst och läsbar text är du inte ens en kandidat. Helheten finns i guiden till GEO.
Måste jag tillåta GPTBot för att synas i ChatGPT-sök?
Nej. Enligt OpenAI är det OAI-SearchBot som styr om din sajt kan lyftas fram i ChatGPT:s sökfunktioner. GPTBot gäller insamling för träning. Du kan neka GPTBot och tillåta OAI-SearchBot.
Hindrar Google-Extended att jag visas i AI Overviews?
Nej. Google-Extended styr träning av Gemini-modeller och grounding i Gemini-apparna och Vertex AI. AI Overviews och AI Mode är en del av Google Sök och styrs via Googlebot och utdragsreglerna nosnippet, max-snippet och noindex.
Behövs särskild märkning för att synas i AI-svar?
Google skriver att inga särskilda optimeringar eller ny märkning krävs för AI Overviews och AI Mode utöver vanlig, god sökmotoroptimering. Övriga leverantörer ställer inga dokumenterade krav på särskild märkning. Strukturerad data kan fortfarande hjälpa system att förstå sidan, men det är inget inträdeskrav.