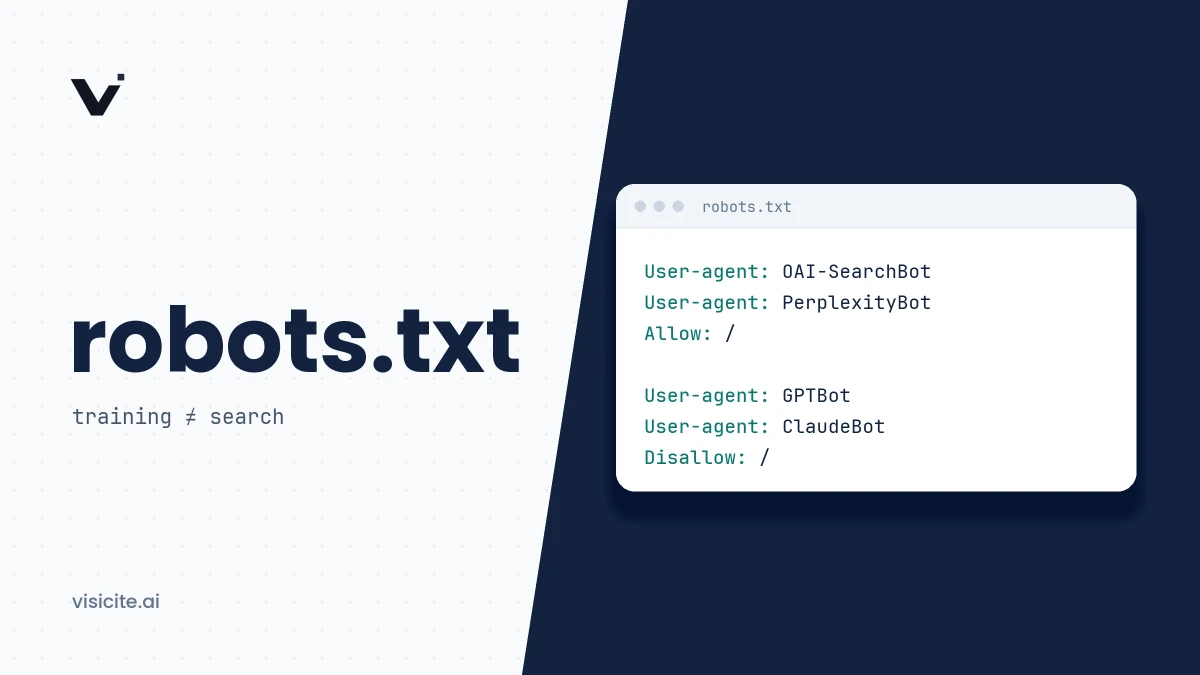

Med robots.txt styr du vilka AI-crawlers som får hämta dina sidor, men bara de som väljer att följa filen. Det viktigaste att förstå är att AI-bolagen använder olika botar för olika syften: en för att samla träningsdata, en för att bygga sökindex och en som hämtar sidor när en användare ber om det. Att blockera träningsboten stänger inte ute dig från AI-sök, och att tillåta sökboten säger ingenting om träning.
I korthet
- Skilj på tre sorters botar: träning (till exempel GPTBot, ClaudeBot), sökindex (OAI-SearchBot, Claude-SearchBot, PerplexityBot) och användarstyrda hämtningar (ChatGPT-User, Claude-User, Perplexity-User).
- Google AI Overviews och AI Mode styrs via Googlebot, inte via Google-Extended. Google-Extended gäller Gemini-träning och grounding i Gemini-appen och Vertex AI.
- En grupp för en namngiven bot ersätter gruppen för
*. Den ärver inga regler. - robots.txt är en frivillig överenskommelse, inte ett åtkomstskydd. Flera användarstyrda botar följer den inte fullt ut enligt leverantörerna själva.
- Om en bot är tillåten i robots.txt men ändå inte når sajten är orsaken ofta botskyddet i ett CDN eller en brandvägg.
Tre sorters AI-botar och varför skillnaden spelar roll
Nästan alla frågor om robots.txt och AI blir enklare när du delar in botarna efter syfte:
- Träningsbotar samlar in innehåll som kan användas för att träna framtida modeller. Att blockera dem påverkar inte om du visas i AI-sök i dag.
- Sökbotar bygger det index som AI-tjänsten söker i när den svarar med källhänvisningar. Blockerar du dem kan du inte bli citerad från det indexet.
- Användarstyrda hämtningar sker när en person ber assistenten läsa en viss sida eller när assistenten slår upp något i realtid. De räknas av flera leverantörer inte som crawling.
OpenAI skriver uttryckligen att inställningarna är oberoende av varandra: du kan tillåta OAI-SearchBot för att synas i ChatGPT:s sökresultat och samtidigt stänga ute GPTBot för att markera att innehållet inte ska användas för träning. Samma uppdelning finns hos Anthropic, Perplexity, Apple och Amazon. Hur sökindexen sedan används när ett svar byggs beskriver vi i guiden om hur AI-sökmotorer fungerar.
AI-botarna enligt leverantörernas egen dokumentation
Tabellen bygger enbart på respektive leverantörs officiella dokumentation, kontrollerad i november 2026. Kolumnen om robots.txt återger vad leverantören själv säger, inte vad oberoende mätningar visar.
| Token i robots.txt | Syfte | Följer robots.txt enligt leverantören |
|---|---|---|
| GPTBot (OpenAI) | Träning av OpenAI:s grundmodeller | Ja. Disallow betyder att innehållet inte ska användas för träning. |
| OAI-SearchBot (OpenAI) | Sökindex för ChatGPT:s sökfunktioner | Ja. Blockerade sajter visas inte i sökbaserade svar, men kan förekomma som rena navigeringslänkar. |
| ChatGPT-User (OpenAI) | Hämtning på användarens begäran i ChatGPT och Custom GPTs | Inte säkert. OpenAI skriver att robots.txt-regler "may not apply" eftersom användaren startar hämtningen. |
| ClaudeBot (Anthropic) | Insamling av innehåll som kan användas för träning | Ja. Blockering signalerar att framtida material ska uteslutas ur träningsdata. |
| Claude-SearchBot (Anthropic) | Indexering för att förbättra sökresultat i Claude | Ja |
| Claude-User (Anthropic) | Hämtning när en användare ställer en fråga till Claude | Ja. Anthropic anger att blockering hindrar hämtning vid användarfrågor. |
| Googlebot (Google) | Googles sökindex, som även AI Overviews och AI Mode bygger på | Ja |
| Google-Extended (Google) | Ingen egen crawler. En kontrolltoken för Gemini-träning och grounding i Gemini-appen och Vertex AI. | Ja. Påverkar inte Google Sök och är ingen rankningssignal. |
| PerplexityBot (Perplexity) | Sökindex för Perplexity. Används enligt Perplexity inte för träning av grundmodeller. | Ja |
| Perplexity-User (Perplexity) | Hämtning när en användare ställer en fråga | Nej. Perplexity skriver att den "generally ignores robots.txt rules". |
| Applebot (Apple) | Sök i Spotlight, Siri och Safari. Data kan även användas för träning om du inte stänger ute Applebot-Extended. | Ja. Saknas regler för Applebot följer den reglerna för Googlebot. |
| Applebot-Extended (Apple) | Crawlar inte. En kontrolltoken för om Applebots data får användas för att träna Apples modeller. | Ja |
| bingbot (Microsoft) | Bings index, som även ligger till grund för AI-svar i Bing och Copilot | Ja för crawling. AI-användningen styrs med separata preferenser, se nedan. |
| CCBot (Common Crawl) | Öppet arkiv med crawldata som vem som helst kan ladda ned | Ja, enligt Common Crawls instruktion för att blockera boten |
| Amazonbot (Amazon) | Förbättring av Amazons tjänster. Kan användas för att träna Amazons AI-modeller. | Ja |
| Amzn-SearchBot (Amazon) | Sökupplevelser som Alexa. Inte träning. | Ja |
| Amzn-User (Amazon) | Hämtning i realtid för användarens räkning | Delvis. Amazon skriver att den kanske inte följer alla direktiv. |
| Meta-ExternalAgent (Meta) | Träning av grundmodeller och direkt indexering av innehåll | Meta anger robots.txt som sättet att blockera den. |
| Meta-WebIndexer (Meta) | Sökkvalitet i Meta AI | Meta anger robots.txt som sättet att styra den. |
| Meta-ExternalFetcher (Meta) | Hämtning av enskilda länkar på användarens begäran | Inte säkert. Meta skriver att den kan kringgå robots.txt. |
ByteDance crawler Bytespider saknas i tabellen eftersom vi inte har hittat någon officiell dokumentation från ByteDance som beskriver dess syfte eller hur den hanterar robots.txt.
Google: Googlebot och Google-Extended är två olika saker
Det vanligaste missförståndet är att Google-Extended styr AI Overviews. Det gör den inte. Google skriver i sin dokumentation om AI-funktioner i Sök att AI är en inbyggd del av sökmotorn och att robots.txt-reglerna för Googlebot är det som styr crawlingen. Google-Extended avgör i stället om innehåll som Google redan crawlat får användas för att träna kommande Gemini-modeller och för grounding i Gemini-appen och Vertex AI. Den har ingen egen user agent-sträng i dina loggar.
Konsekvensen: om du blockerar Google-Extended syns du fortfarande i Google Sök och kan förekomma i AI Overviews, men du väljer bort grounding i Gemini-appen. Vill du begränsa hur Google använder en sida i AI Overviews och AI Mode får du använda snippet-reglerna längre ned.
Microsoft: nya preferenser från 2027
Microsoft har ingen separat AI-token motsvarande Google-Extended. Sedan 2023 har användningen i AI-svar och träning styrts med metataggarna NoArchive och NoCache. Den 30 oktober 2026 meddelade Microsoft att de ersätts: från den 1 februari 2027 läser Microsoft en träningspreferens i robots.txt (User-Agent: __usage_ai-training) och sidnivåpreferenserna ai-training och ai-grounding i en metatagg eller HTTP-header för Bingbot. Efter den 1 mars 2027 läses NoArchive och NoCache inte längre som AI-preferenser. Använder du de taggarna i dag bör du läsa Microsofts inlägg i sin helhet.
Så läser en crawler din robots.txt
Formatet är standardiserat i RFC 9309. Tre regler orsakar de flesta felen:
- En bot följer bara en grupp. Finns en grupp som namnger boten gäller den gruppen. Gruppen för
*gäller bara botar som inte har en egen grupp. Reglerna slås inte ihop. - Längsta matchande sökväg vinner. Om både en Allow- och en Disallow-regel matchar gäller den mest specifika, alltså den längsta. Är de lika långa gäller Allow.
- Filen gäller per värdnamn.
www.example.comochblogg.example.combehöver var sin robots.txt.
Den första regeln är lätt att gå i fällan på. Här är avsikten att alla botar ska hålla sig borta från /kassa/ och att GPTBot uttryckligen ska vara välkommen:
User-agent: *
Disallow: /kassa/

User-agent: GPTBot
Allow: /
Resultatet är att GPTBot får hämta allt, även /kassa/, eftersom dess egen grupp ersätter *-gruppen. Rätt sätt är att upprepa reglerna:
User-agent: *
Disallow: /kassa/

User-agent: GPTBot
Disallow: /kassa/
Allow: /
Flera User-agent-rader i rad får dela på samma regler. Det gör recepten nedan kortare.
Tre färdiga recept
1. Tillåt allt
Det här är utgångsläget för den som vill synas så brett som möjligt. Saknas robots.txt helt får crawlers också hämta allt, men en uttrycklig fil visar att valet är medvetet och ger dig en plats för undantag som /admin/.
User-agent: *
Disallow: /admin/
Allow: /

Sitemap: https://www.example.com/sitemap.xml
2. Tillåt AI-sök, välj bort träning
Det här passar den som vill bli citerad i AI-svar men inte vill bidra med träningsdata.
# Träning: nej
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: Applebot-Extended
User-agent: CCBot
Disallow: /

# Gemensam träningspreferens (IETF-utkast)
User-agent: __usage_ai-training
Disallow: /

# Alla andra, inklusive sökbotar och AI-sökbotar
User-agent: *
Disallow: /admin/
Allow: /

Sitemap: https://www.example.com/sitemap.xml
Några avvägningar som receptet inte gör åt dig:
- Google-Extended är utelämnad med flit. Lägger du till den väljer du bort Gemini-träning, men också grounding i Gemini-appen. Det är ett rimligt val, men det är ett val som minskar din synlighet där.
- Amazonbot och Meta-ExternalAgent har enligt leverantörerna blandade syften, både träning och annat. Lägg till dem i den första gruppen om träningen väger tyngst för dig.
__usage_ai-trainingkommer från ett IETF-utkast, inte en färdig standard. Anthropic uppger att de började känna igen signalen den 30 oktober 2026 och inför den stegvis, Microsoft börjar följa den 1 februari 2027 och Google skriver att de avser att stödja den i början av 2027. Hos Anthropic går en regel som namnger ClaudeBot före den allmänna signalen.
3. Blockera alla AI-botar
User-agent: GPTBot
User-agent: OAI-SearchBot
User-agent: ChatGPT-User
User-agent: ClaudeBot
User-agent: Claude-SearchBot
User-agent: Claude-User
User-agent: Google-Extended
User-agent: PerplexityBot
User-agent: Perplexity-User
User-agent: Applebot-Extended
User-agent: CCBot
User-agent: Amazonbot
User-agent: Amzn-SearchBot
User-agent: Amzn-User
User-agent: Meta-ExternalAgent
User-agent: Meta-WebIndexer
User-agent: Meta-ExternalFetcher
Disallow: /

User-agent: __usage_ai-training
Disallow: /

User-agent: *
Disallow: /admin/
Allow: /
Receptet har två luckor som du inte kan täppa till i robots.txt. ChatGPT-User, Perplexity-User, Amzn-User och Meta-ExternalFetcher följer enligt leverantörerna inte alltid filen. Och AI-svaren i Google Sök och Bing bygger på Googlebot respektive bingbot, som du inte kan blockera utan att försvinna ur vanlig sökning. Där behövs sidnivåregler i stället.
Det här kan robots.txt inte göra
Den är inget åtkomstskydd. RFC 9309 säger rakt ut att reglerna inte är en form av åtkomstkontroll och att protokollet inte ersätter riktiga säkerhetsåtgärder. Filen är dessutom offentlig, så sökvägar du listar där blir synliga för alla. Innehåll som inte får läsas ska ligga bakom inloggning.
Den tar inte bort det som redan samlats in. Anthropic beskriver till exempel blockering av ClaudeBot som en signal om att framtida material ska uteslutas. Ändringar slår inte heller igenom direkt: både OpenAI och Perplexity uppger att det kan ta ungefär ett dygn.
Den styr inte hur Google visar eller använder en sida i AI-svar. För det finns reglerna i Googles specifikation för robots-metataggar:
noindexhåller sidan utanför sökresultaten helt.nosnippetstoppar textutdrag och hindrar enligt Google att innehållet används som direkt indata till AI Overviews och AI Mode.max-snippet:[antal]begränsar utdragets längd och därmed hur mycket som får användas som direkt indata.data-nosnippetär ett HTML-attribut som undantar ett enskilt stycke.
<meta name="robots" content="max-snippet:160">

<p>Den här texten får visas i utdrag.
<span data-nosnippet>Den här texten får det inte.</span></p>
Tänk på att dessa regler bara kan läsas om crawlern får hämta sidan. En sida som är blockerad i robots.txt kan alltså inte samtidigt förmedla noindex eller nosnippet. Tänk också på att hårda snippetgränser minskar din synlighet i AI-svar, vilket sällan är målet för den som arbetar med GEO.
Den dolda orsaken: CDN och brandvägg
En bot som är tillåten i robots.txt kan ändå mötas av en blockering eller en utmaning i ett CDN, en brandvägg (WAF) eller ett botskydd hos webbhotellet. Det märks inte i robots.txt och sällan i vanlig webbanalys. Leverantörerna tar själva upp problemet: OpenAI rekommenderar att du släpper igenom anrop från deras publicerade IP-intervall, Perplexity har en egen instruktion för hur man konfigurerar Cloudflare WAF och AWS WAF, och Anthropic påpekar att IP-blockering kan hindra deras botar från att ens läsa din robots.txt. Kontrollera därför botinställningarna i ditt CDN innan du felsöker något annat. Det hör till de tekniska faktorer som avgör om resten av arbetet spelar någon roll.
Kontrollera i serverloggarna
robots.txt beskriver vad du tillåter. Loggarna visar vad som faktiskt händer. Gör så här:
- Hämta filen själv och kontrollera att den svarar med status 200 och rätt innehåll på varje värdnamn:
curl -i https://www.example.com/robots.txt - Räkna statuskoder per AI-bot. Exemplet förutsätter loggformatet combined, där statuskoden är fält nio:
Många svar med 403, 429 eller 503 för botar du tillåter tyder på att något annat än robots.txt blockerar.grep -E "GPTBot|OAI-SearchBot|ChatGPT-User|ClaudeBot|Claude-SearchBot|Claude-User|PerplexityBot|Perplexity-User" /var/log/nginx/access.log \ | awk '{print $9}' | sort | uniq -c - Kontrollera att boten är äkta. User agent-strängar går att förfalska. OpenAI och Perplexity publicerar IP-intervall för varje bot som JSON, och Common Crawl beskriver hur du verifierar CCBot med omvänd DNS-uppslagning.
- Testa botskyddet utifrån. Ett anrop med en bots user agent visar om sajten blockerar på user agent. Det fångar däremot inte regler som bygger på IP-adress.
curl -I -A "Mozilla/5.0 (compatible; PerplexityBot/1.0; +https://perplexity.ai/perplexitybot)" https://www.example.com/
Om loggarna ligger i ditt CDN och inte på servern är det där du ska titta. Anrop som stoppas i CDN:et når aldrig serverloggen.
Vanliga frågor
Ska jag blockera eller tillåta AI-botar?
Det beror på vad du vill uppnå. Vill du bli citerad i AI-svar behöver sökbotarna och de användarstyrda hämtningarna komma åt sidorna. Träningsbotarna är ett separat beslut som handlar om hur du ser på att ditt innehåll används för modellträning. Åtkomst är en förutsättning för synlighet, inte en garanti.
Syns jag i ChatGPT om jag blockerar GPTBot?
Ja, det kan du göra. Enligt OpenAI styr GPTBot träning medan OAI-SearchBot styr om sajten kan visas i ChatGPT:s söksvar. Inställningarna är oberoende av varandra.
Styr Google-Extended om jag visas i AI Overviews?
Nej. Google anger att Google-Extended inte påverkar Google Sök. AI Overviews och AI Mode bygger på Googlebots crawling och begränsas med nosnippet, max-snippet, data-nosnippet eller noindex.
Följer alla AI-botar robots.txt?
Nej. De stora leverantörerna uppger att deras automatiska crawlers följer filen, men flera skriver själva att användarstyrda hämtningar inte alltid gör det. Okända eller oseriösa botar är inte bundna av något alls. Behöver du faktiskt stoppa åtkomst krävs inloggning eller blockering i brandvägg.
Hur lång tid tar det innan en ändring gäller?
Räkna med ungefär ett dygn. OpenAI och Perplexity anger cirka 24 timmar, och RFC 9309 säger att en crawler inte bör använda en cachad robots.txt längre än så.
Nästa steg
Bestäm först vad du vill: synas i AI-sök, välja bort träning eller båda. Välj sedan ett recept, kontrollera CDN-inställningarna och bekräfta i loggarna. Vill du ha en snabb kontroll kan du köra Visicites kostnadsfria skanning, som bland annat granskar hur robots.txt behandlar AI-botar för träning och sök. När åtkomsten är på plats är nästa steg llms.txt, strukturerad data och resten av GEO-checklistan.