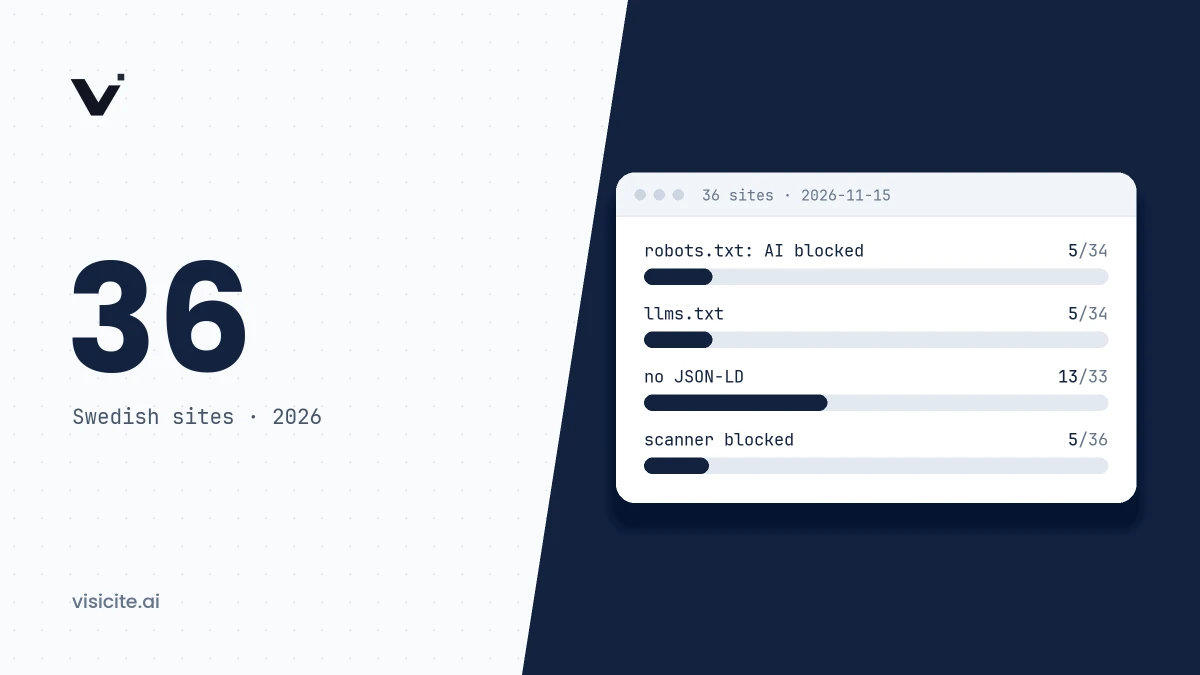

Vi granskade startsidan på 36 stora svenska webbplatser den 15 november 2026. Ingen utanför mediebranschen stänger ute AI-tjänsternas crawlers i robots.txt, men 26 av 34 nämner dem inte alls. Fem av 34 har en llms.txt, och 13 av 33 startsidor saknar strukturerad data helt. Fem sajter släppte inte in vår skanner över huvud taget. Här är hela resultatet, hur vi mätte och vad siffrorna inte säger.
I korthet
- Bara medierna har tagit ställning. Alla fem nyhetssajter blockerar minst en AI-crawler i robots.txt. Ingen av de övriga 29 sajterna vars robots.txt gick att läsa blockerar någon.
- De flesta har inte gjort något val. 26 av 34 sajter nämner inte en enda AI-crawler i robots.txt. De är öppna, men av allt att döma inte genom ett uttalat beslut.
- llms.txt är ovanligt. Fem av 34 sajter har en fungerande llms.txt. Två svarar med en vanlig HTML-sida på adressen.
- Strukturerad data saknas ofta. 13 av 33 startsidor har ingen JSON-LD i HTML-koden. Bland de fem myndigheterna har bara en det.
- Botskydd stoppar mer än robots.txt. Fem av 36 sajter svarade vår skanner med en spärrsida i stället för startsidan, även när deras robots.txt tillåter automatiska besökare.
Vad vi undersökte
Urvalet är 36 välkända svenska webbplatser i åtta branscher: medier, handel, bank och försäkring, telekom och energi, myndigheter, resor och transport, industri och marknadsplatser. Det är inget slumpmässigt urval och ingen topplista över Sveriges mest besökta sajter, utan ett tvärsnitt av stora aktörer som de flesta svenskar känner till.
För varje sajt gjorde vi två saker den 15 november 2026:
- Visicites gratisanalys av startsidan. Det är samma analys som vem som helst kan köra på gratisanalysens sida: regelbaserade kontroller av teknisk åtkomst, strukturerad data, innehållsstruktur och avsändaruppgifter, sammanvägda till en poäng mellan 0 och 100.
- En oberoende kontroll. Vi hämtade varje sajts robots.txt, llms.txt och startsidans HTML direkt och tolkade robots.txt med en parser som följer standarden RFC 9309. Alla uppgifter om robots.txt, llms.txt och JSON-LD i den här artikeln kommer från den kontrollen, inte från poängen.
Den andra kontrollen gjorde nytta. Den avslöjade fem fel i vår egen skanner, bland annat att den underkände strukturerad data skriven i @graph-format och godkände en HTML-felsida som llms.txt. Felen är rättade och alla sajter skannades om innan resultaten sammanställdes.
AI-crawlers i robots.txt: medierna mot alla andra
AI-företagen använder olika crawlers för olika syften. GPTBot, ClaudeBot och Google-Extended gäller träning av modeller. OAI-SearchBot, Claude-SearchBot och PerplexityBot bygger de sökindex som ChatGPT, Claude och Perplexity hämtar källor från. Skillnaden förklaras i guiden till robots.txt för AI-crawlers.
Robots.txt gick att läsa för 34 av de 36 sajterna. Två, ica.se och hm.com, svarade med felkoden 403 på vår förfrågan.
| Hållning i robots.txt | Antal sajter | Vilka |
|---|---|---|
| Nämner ingen AI-crawler | 26 | Alla myndigheter, banker och telekombolag i urvalet, och de flesta handlare |
| Namnger AI-crawlers utan att stänga ute någon från sajten | 3 | apotea.se, elgiganten.se, volvocars.com |
| Blockerar träning, tillåter AI-sök | 1 | svt.se |
| Blockerar träning och delar av AI-sök | 2 | aftonbladet.se, svd.se |
| Blockerar både träning och AI-sök | 2 | dn.se, expressen.se |
De fem nyhetssajterna har valt tre olika linjer:
- dn.se och expressen.se stänger ute både träningscrawlers och sökcrawlers från OpenAI, Anthropic och Perplexity, och dessutom de botar som hämtar en sida när en användare ber om det (ChatGPT-User, Claude-User, Perplexity-User).
- aftonbladet.se och svd.se blockerar ClaudeBot, Claude-SearchBot, PerplexityBot, Google-Extended och CCBot, men varken GPTBot eller OAI-SearchBot.
- svt.se blockerar träningscrawlers som GPTBot, ClaudeBot och Google-Extended men släpper uttryckligen in de tre sökcrawlerna.
Ingen sajt i urvalet blockerar Googlebot eller bingbot. Det är värt att notera, eftersom AI-svaren i Google Sök bygger på Googlebots index. Att stänga ute Google-Extended påverkar enligt Googles dokumentation inte Google Sök.
svt.se och apotea.se använder dessutom rader som börjar med Content-Signal, ett förslag till tillägg i robots.txt, för att ange hur innehållet får användas. SVT skriver ai-train=no, search=yes, ai-input=yes för sökcrawlerna. Apotea skriver search=yes, ai-input=yes, ai-train=yes. Det är de två tydligaste exemplen i urvalet på ett uttalat val, åt var sitt håll.
För de 26 sajter som inte nämner AI-crawlers gäller standardregeln: allt som inte är förbjudet är tillåtet. Resultatet är öppenhet, men vi kan inte se om den är avsiktlig. Det spelar roll den dag någon i organisationen frågar om innehållet används för att träna AI-modeller, för svaret är då ja, så länge ingen har sagt nej.
llms.txt: fem av 34
En fungerande llms.txt, alltså en textfil i Markdown-format på adressen /llms.txt, finns hos fem sajter: apotea.se, coop.se, elgiganten.se, klarna.com och tele2.se. Det motsvarar 15 procent av de 34 sajter där adressen gick att kontrollera.
Två sajter, postnord.se och sj.se, svarar på adressen med statuskoden 200 men skickar en vanlig HTML-sida. För en människa ser det ut som en sida som inte finns, för ett program ser det ut som att filen finns. Det är ett vanligt fel och ett bra skäl att låta adresser som saknas svara med 404.
Hur mycket filen betyder är en öppen fråga. Den är ett förslag, inte en standard, och Google skriver i sin dokumentation om AI-funktioner att inga särskilda AI-filer behövs för att synas där. Bakgrunden finns i guiden till llms.txt.
Strukturerad data: var tredje startsida saknar JSON-LD
Startsidans HTML gick att hämta för 33 sajter. Av dem har 20 någon form av JSON-LD och 13 ingen alls: arbetsformedlingen.se, clasohlson.com, coop.se, forsakringskassan.se, klarna.com, nordea.se, polisen.se, seb.se, sj.se, skatteverket.se, svt.se, systembolaget.se och tele2.se.
18 av de 33 beskriver sig själva med en organisationstyp, till exempel Organization, NewsMediaOrganization eller OnlineStore. Det är den uppgift som gör det entydigt vem som står bakom sajten.
Två förbehåll. Vi har läst HTML-koden som servern skickar, så strukturerad data som läggs till med JavaScript i efterhand räknas inte. Och startsidan är inte hela sajten: en sajt kan ha utmärkt strukturerad data på produkt- och artikelsidor utan att ha någon på startsidan. Strukturerad data är heller inget krav för att synas i AI-svar, men den gör uppgifter entydiga. Mer om det i guiden till JSON-LD och strukturerad data.
Rubriker och JavaScript
Fem av 33 startsidor har ingen H1-rubrik i HTML-koden från servern: aftonbladet.se, coop.se, expressen.se, svd.se och telenor.se. Hos coop.se och telenor.se dyker rubriken upp först när JavaScript har körts. Åtta sajter har mer än en H1, och svt.se har 60, eftersom varje nyhetsrubrik på startsidan är märkt som H1.
Fyra av de 31 sajter som skannern kunde analysera är starkt beroende av JavaScript för att visa sitt innehåll: coop.se, ica.se, sj.se och telenor.se. Google renderar JavaScript. För övriga AI-tjänsters crawlers är det inte dokumenterat att de gör det, vilket vi går igenom i artikeln om tekniska faktorer för AI-synlighet. Innehåll som bara finns efter rendering riskerar alltså att vara osynligt för dem.
Fem sajter stoppade skannern
Fem av 36 sajter svarade inte med sin startsida när vår skanner hämtade den:
| Sajt | Svar till skannern | Vanlig webbläsarförfrågan från samma dator |
|---|---|---|
| hm.com | 403, "Access Denied" | 403 |
| volvocars.com | 403, "Access Denied" | 403 |
| elgiganten.se | 429, säkerhetskontroll | 200 |
| dn.se | 406 | 200 |
| expressen.se | 406 | 200 |
Det här säger ingenting om hur sajterna behandlar OpenAI:s, Anthropics eller Googles crawlers. Vår skanner är inte en av dem, och botskydd släpper ofta igenom kända crawlers som kan verifieras via sina IP-adresser. Svaren varierade dessutom: vid en tidigare körning samma dag fick skannern startsidan från dn.se och expressen.se.
Men mönstret är värt att känna till, av två skäl. Det första är att botskyddet sitter framför robots.txt. volvocars.com namnger ett tjugotal AI-crawlers i sin robots.txt och stänger bara ute dem från vissa delar av sajten, och elgiganten.se har både en llms.txt och egna regler för AI-tjänsternas användarstyrda hämtare. Ändå stoppades vår automatiska hämtning hos båda av en spärr som inte syns i någon av filerna. Robots.txt beskriver vad en sajt vill tillåta, brandväggen avgör vad som faktiskt händer.
Det andra är att den som ansvarar för innehållet sällan är den som ställer in botskyddet. Vill du veta om AI-crawlers faktiskt når din sajt räcker det inte att läsa robots.txt. Du behöver titta i serverloggarna efter deras user agent och se vilken statuskod de fick.
De fem sajterna har ingen poäng i tabellen nedan, eftersom skannern analyserade en spärrsida och inte deras innehåll.
Poäng per sajt och bransch
För de 31 sajter som gick att analysera blev medelpoängen 79 och medianen 78, med 52 som lägsta och 96 som högsta värde.
| Bransch | Antal sajter | Medelpoäng |
|---|---|---|
| Industri och fordon | 1 | 90 |
| Telekom och energi | 4 | 86 |
| Marknadsplatser | 2 | 84 |
| Resor och transport | 3 | 79 |
| Handel | 6 | 78 |
| Medier | 3 | 77 |
| Myndigheter och offentlig sektor | 5 | 76 |
| Bank och försäkring | 7 | 75 |
Läs branschsiffrorna försiktigt. Grupperna är små, från en till sju sajter, och skillnaderna mellan dem är mindre än spridningen inom dem.
Hela resultatet, sorterat efter poäng:
| Sajt | Bransch | Poäng | AI-crawlers i robots.txt | llms.txt | JSON-LD på startsidan |
|---|---|---|---|---|---|
| vattenfall.se | Telekom och energi | 96 | Inga AI-crawlers blockerade | Nej | Organization |
| hemnet.se | Marknadsplatser | 93 | Inga AI-crawlers blockerade | Nej | Organization |
| handelsbanken.se | Bank och försäkring | 91 | Inga AI-crawlers blockerade | Nej | FAQPage |
| scania.com | Industri och fordon | 90 | Inga AI-crawlers blockerade | Nej | Organization |
| telia.se | Telekom och energi | 90 | Inga AI-crawlers blockerade | Nej | Organization |
| 1177.se | Myndigheter och offentlig sektor | 86 | Inga AI-crawlers blockerade | Nej | Organization, WebPage |
| postnord.se | Resor och transport | 86 | Inga AI-crawlers blockerade | Nej | Organization |
| telenor.se | Telekom och energi | 86 | Inga AI-crawlers blockerade | Nej | Organization |
| folksam.se | Bank och försäkring | 85 | Inga AI-crawlers blockerade | Nej | Organization |
| ikea.com | Handel | 85 | Inga AI-crawlers blockerade | Nej | FurnitureStore, OnlineStore, WebSite |
| apotea.se | Handel | 84 | Inga AI-crawlers blockerade | Ja | OnlineStore, WebSite |
| ica.se | Handel | 84 | Gick inte att läsa | – | – |
| lansforsakringar.se | Bank och försäkring | 82 | Inga AI-crawlers blockerade | Nej | Organization, WebPage, WebSite |
| sas.se | Resor och transport | 82 | Inga AI-crawlers blockerade | Nej | Airline, WebSite |
| svd.se | Medier | 82 | Blockerar träning samt Claude-SearchBot och PerplexityBot | Nej | NewsMediaOrganization |
| aftonbladet.se | Medier | 78 | Blockerar träning samt Claude-SearchBot och PerplexityBot | Nej | NewsMediaOrganization, WebPage |
| nordea.se | Bank och försäkring | 76 | Inga AI-crawlers blockerade | Nej | Ingen |
| arbetsformedlingen.se | Myndigheter och offentlig sektor | 75 | Inga AI-crawlers blockerade | Nej | Ingen |
| polisen.se | Myndigheter och offentlig sektor | 75 | Inga AI-crawlers blockerade | Nej | Ingen |
| blocket.se | Marknadsplatser | 74 | Inga AI-crawlers blockerade | Nej | Organization |
| forsakringskassan.se | Myndigheter och offentlig sektor | 74 | Inga AI-crawlers blockerade | Nej | Ingen |
| swedbank.se | Bank och försäkring | 74 | Inga AI-crawlers blockerade | Nej | BreadcrumbList |
| systembolaget.se | Handel | 74 | Inga AI-crawlers blockerade | Nej | Ingen |
| coop.se | Handel | 73 | Inga AI-crawlers blockerade | Ja | Ingen |
| skatteverket.se | Myndigheter och offentlig sektor | 72 | Inga AI-crawlers blockerade | Nej | Ingen |
| svt.se | Medier | 71 | Blockerar träning, tillåter AI-sök | Nej | Ingen |
| sj.se | Resor och transport | 70 | Inga AI-crawlers blockerade | Nej | Ingen |
| tele2.se | Telekom och energi | 70 | Inga AI-crawlers blockerade | Ja | Ingen |
| seb.se | Bank och försäkring | 68 | Inga AI-crawlers blockerade | Nej | Ingen |
| clasohlson.com | Handel | 67 | Inga AI-crawlers blockerade | Nej | Ingen |
| klarna.com | Bank och försäkring | 52 | Inga AI-crawlers blockerade | Ja | Ingen |
| dn.se | Medier | Blockerad | Blockerar träning och AI-sök | Nej | NewsMediaOrganization |
| elgiganten.se | Handel | Blockerad | Inga AI-crawlers blockerade | Ja | OnlineStore, WebSite |
| expressen.se | Medier | Blockerad | Blockerar träning och AI-sök | Nej | NewsMediaOrganization, WebPage |
| hm.com | Handel | Blockerad | Gick inte att läsa | – | – |
| volvocars.com | Industri och fordon | Blockerad | Inga AI-crawlers blockerade | Nej | – |
Kolumnen för AI-crawlers bygger på vår tolkning av robots.txt för startsidan. "Träning" avser GPTBot, ClaudeBot, Google-Extended, Applebot-Extended, CCBot och Bytespider, "AI-sök" avser OAI-SearchBot, Claude-SearchBot och PerplexityBot. Kolumnen för JSON-LD visar de viktigaste typerna i HTML-koden från servern. Ett streck betyder att uppgiften inte gick att hämta.
Vad poängen inte säger
- Den mäter förutsättningar, inte utfall. Poängen visar hur väl en sida uppfyller kända och rimliga tekniska förutsättningar. Den visar inte om sajten citeras i AI-svar. En stor bank eller myndighet citeras på grund av vad den är, oavsett H1-rubriker.
- Den gäller en sida. Vi har analyserat startsidan, som ofta är en ingång med lite text. Undersidorna kan se helt annorlunda ut.
- Den är inte helt jämförbar mellan sajter. Skannern kör olika många kontroller beroende på vilken typ av sida den bedömer att den tittar på, mellan 24 och 36 i det här urvalet. Två sajter med samma poäng har alltså inte nödvändigtvis bedömts på exakt samma punkter.
- Den är en ögonblicksbild. Allt mättes den 15 november 2026. En robots.txt kan ändras på en minut.
- Att blockera kan vara rätt beslut. Ett medieföretag som stänger ute träningscrawlers får lägre poäng på den kontrollen hos oss, men gör ett affärsmässigt val om sitt innehåll. Poängen värderar öppenhet, inte affärsstrategi.
Tre saker att ta med sig
- Gör ett uttalat val om AI-crawlers. 26 av 34 stora svenska sajter har inte gjort det. Bestäm om ni vill bidra till träning och om ni vill synas i AI-sök, och skriv in det i robots.txt. Det är två olika beslut och de styrs var för sig.
- Kontrollera vad som faktiskt händer, inte bara vad filerna säger. Botskydd i CDN och brandvägg kan stoppa besökare som robots.txt välkomnar. Serverloggarna visar sanningen.
- Beskriv vem ni är på startsidan. En tredjedel av startsidorna saknar strukturerad data. En Organization-markering med namn, logotyp och länkar till era officiella profiler är en liten insats.
Vill du se hur din egen startsida står sig mot samma kontroller kan du köra gratisanalysen. Bakgrunden till kontrollerna finns i guiden till GEO-optimering.
Vanliga frågor om undersökningen
Hur valdes sajterna ut?
Vi valde välkända svenska webbplatser med stor publik i åtta branscher. Urvalet är inte slumpmässigt och gör inte anspråk på att vara de 36 största sajterna i Sverige. Fyra sajter lades till i efterhand för att kompensera för dem som stoppade skannern.
Blockerar svenska sajter ChatGPT?
I vårt urval gör bara nyhetsmedierna det. dn.se, expressen.se och svt.se blockerar OpenAI:s träningscrawler GPTBot. dn.se och expressen.se blockerar även sökcrawlern OAI-SearchBot, vilket enligt OpenAI:s dokumentation innebär att sidorna inte visas i ChatGPT:s söksvar. Ingen bank, myndighet, handlare eller teleoperatör i urvalet blockerar någon av dem i robots.txt.
Kan jag få hela datasetet?
Tabellen ovan innehåller de viktigaste uppgifterna per sajt. Du kan upprepa analysen själv genom att köra gratisanalysen på vilken som helst av startsidorna och läsa sajtens robots.txt och llms.txt direkt i webbläsaren.
Kommer undersökningen att upprepas?
Mätningen är gjord så att den går att köra om med samma lista och samma kontroller. Den här artikeln beskriver läget den 15 november 2026.