
Ingen av de stora AI-leverantörerna har publicerat en lista över vilka auktoritetssignaler som avgör vilka källor deras AI-svar citerar. Google och Microsoft hänvisar till samma ranknings- och kvalitetssystem som i vanlig sökning, och där finns länkar och trovärdighet dokumenterade som faktorer. OpenAI, Anthropic och Perplexity dokumenterar i huvudsak hur man ger eller nekar åtkomst. Forskningen visar framför allt vad som påverkar synlighet i testmiljöer och hur modeller väger texter de redan fått, inte hur länkar eller E-E-A-T vägs i produktionssystem.
Sammanfattning
- Google säger att AI Overviews och AI Mode bygger på Googles sökssystem. Sidor som är indexerade och får visas med utdrag kan visas som källa, och Google anger att det inte finns några ytterligare tekniska krav.
- Microsofts riktlinjer för Bing nämner uttryckligen rykte, länkar och transparent författarskap som delar av kvalitet och trovärdighet. Kopplingen till exakt vilka källor Copilot citerar är däremot inte beskriven i detalj.
- OpenAI, Anthropic och Perplexity beskriver sina crawlers, men inga rankningskriterier för val av källor.
- Publicerad forskning tyder på att relevans och innehållets utformning väger tungt när modellen väl har texten framför sig. Forskningen säger lite om länkar och E-E-A-T i verkliga AI-tjänster.
- Det du kan göra oavsett är detsamma som för sökbarhet och trovärdighet i allmänhet: vara hämtbar, vara relevant, vara tydlig med vem som står bakom innehållet och bli omnämnd av andra av goda skäl.
Varför är frågan svår att besvara?
En AI-tjänst med webbsökning väljer källor i minst två steg. I det första steget hämtar ett söksystem kandidatsidor och rangordnar dem. I det andra steget läser språkmodellen ett urval av texterna och formulerar ett svar, där vissa källor citeras och andra inte. Auktoritetssignaler som länkar och avsändarens rykte kan påverka det första steget, medan modellens bedömning av texten påverkar det andra. Hur processen ser ut i stort beskrivs i Så fungerar AI-sökmotorer: träningsdata, hämtning och källhänvisningar, och modellens perspektiv i Hur stora språkmodeller väljer sina källor.
Problemet för den som vill förstå auktoritetssignaler är att leverantörerna sällan säger vilket steg en viss signal påverkar, eller om den påverkar något alls. Därför är det nödvändigt att skilja på vad som är dokumenterat, vad som är ett rimligt antagande och vad som är okänt.
Vad säger leverantörerna själva?
Tabellen sammanfattar vad respektive leverantör har publicerat i sin egen dokumentation, enligt läget i november 2026. Allt som inte står i tabellens mittkolumn ska betraktas som odokumenterat.
| Leverantör | Dokumenterat | Inte publicerat |
|---|---|---|
| Google (AI Overviews, AI Mode) | Sidan måste vara indexerad och kunna visas med utdrag. Inga ytterligare tekniska krav. Samma grundläggande SEO-praxis gäller. E-E-A-T beskrivs i riktlinjerna för hjälpsamt innehåll, där Google skriver att E-E-A-T i sig inte är en specifik rankningsfaktor. | Hur källor väljs ut bland rankade sidor för just AI-svaret. |
| Microsoft (Bing, Copilot) | Bing Webmaster Guidelines beskriver kvalitet och trovärdighet, inklusive webbplatsens rykte (bland annat vilka sajter som länkar dit) och transparens kring författarskap. | Hur dessa faktorer vägs när Copilot väljer vilka källor som citeras. |
| OpenAI (ChatGPT search) | OAI-SearchBot används för att sidor ska kunna visas i ChatGPTs sökresultat. Sajter som blockerar den kan uteslutas. | Rankningskriterier och auktoritetsbedömning. |
| Anthropic (Claude) | Separata botar för träning, sökindexering och användarinitierad hämtning, med styrning via robots.txt. | Hur källor väljs och rangordnas i Claudes webbsökning. |
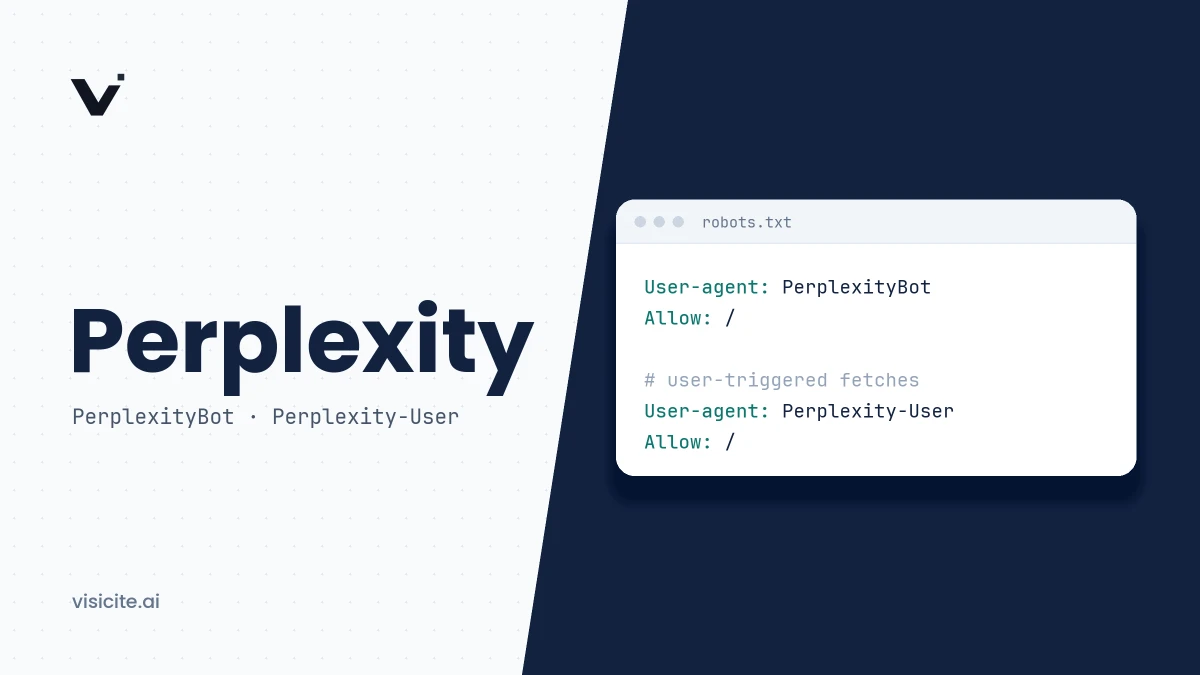
| Perplexity | PerplexityBot för att visa sidor i sökresultat och Perplexity-User för användarinitierade hämtningar. | Rankningsfaktorer och eventuell auktoritetsbedömning. |
Den praktiska följden av tabellen är att Google och Microsoft är de enda leverantörerna där det finns ett dokumenterat samband mellan auktoritetsliknande signaler och söksystemet bakom AI-svaren. För övriga leverantörer är allt utöver teknisk åtkomst antaganden. Detaljerna om crawlers finns i Robots.txt för AI-crawlers och om Perplexity specifikt i Så fungerar Perplexity.
Vad betyder Googles formulering om E-E-A-T i praktiken?
Google skriver att E-E-A-T i sig inte är en specifik rankningsfaktor, men att systemen använder en blandning av faktorer som kan identifiera innehåll med god E-E-A-T, och att förtroende (trust) är den viktigaste delen. Google anger också att kvalitetsbedömarnas betyg inte direkt påverkar rankningen. E-E-A-T är alltså ett ramverk för vad systemen försöker belöna, inte en mätbar poäng. Det finns ingen Google-dokumentation som säger att AI-funktionerna gör en egen, separat E-E-A-T-bedömning. Mer om Googles egna formuleringar finns i E-E-A-T och AI-svar: vad Google faktiskt säger.
Vad säger Google om länkar?
Googles guide till rankningssystemen i Sök beskriver system för länkanalys, inklusive PageRank, som en del av kärnrankningen. Googles spampolicyer förbjuder samtidigt länkmanipulation. Eftersom AI Overviews och AI Mode enligt Google bygger på samma söksystem är det rimligt att anta att länkar påverkar vilka sidor som blir kandidater. Google har inte publicerat något om att länkar påverkar valet bland kandidaterna i AI-svaret.
Vad visar publicerad forskning?
Forskningen om AI-citeringar är ung, och de flesta studier använder testmiljöer, egna datamängder eller öppna modeller i stället för de kommersiella tjänsterna som de ser ut i dag. Resultaten säger därför mer om mekanismer än om exakt hur ChatGPT eller AI Overviews beter sig. En bredare genomgång finns i genomgången av GEO-forskningen 2025 och 2026. Här lyfts bara de studier som berör auktoritet.
GEO-studien från Princeton med flera (2023, publicerad vid KDD 2024)
Aggarwal och medförfattare testade i artikeln "GEO: Generative Engine Optimization" olika sätt att skriva om innehåll och mätte synligheten i genererade svar. Att lägga till källhänvisningar, citat från relevanta källor och statistik gav bäst effekt i deras testmiljö, enligt författarna upp till 40 procents ökad synlighet. Studien mätte innehållsförändringar på sidan, inte länkar eller avsändarens rykte. Den visar att signaler om underbyggnad inne i texten kan spela roll, inte att extern auktoritet gör det.
Vad modeller finner övertygande (Wan, Wallace och Klein, ACL 2024)
Studien "What Evidence Do Language Models Find Convincing?" undersökte vilka texter modeller går på när källor motsäger varandra. Författarna fann att modellerna i hög grad förlitade sig på hur relevant texten var för frågan, och i stort bortsåg från stilistiska drag som människor tycker är viktiga, till exempel om texten innehöll vetenskapliga referenser eller hade neutral ton. Resultatet gäller modellsteget, inte hämtningen. Det talar emot antagandet att modellen själv gör en noggrann trovärdighetsbedömning av texten den läser.
Verifierbarhet i generativa sökmotorer (Liu, Zhang och Liang, 2023)
Liu och medförfattare granskade svar från flera generativa sökmotorer och fann att ungefär hälften av de genererade meningarna (51,5 procent) var fullt underbyggda av sina källhänvisningar, och att 74,5 procent av hänvisningarna stödde den mening de var kopplade till. Studien gäller systemen som de såg ut 2023. Den påminner om att en citering inte nödvändigtvis betyder att källan bedömts som auktoritativ, och att kopplingen mellan text och källa kan vara lös.
Tredjepartskällor jämfört med egna kanaler (Chen med flera, 2025)
Preprinten "Generative Engine Optimization: How to Dominate AI Search" (2025) jämförde källorna i AI-söktjänster med Googles sökresultat och rapporterade att AI-tjänsterna i högre grad hänvisade till tredjepartskällor, så kallad earned media, än till varumärkenas egna sajter. Studien är inte referentgranskad och gäller en viss tidpunkt och ett visst urval av frågor. Den är ändå ett av få försök att mäta omnämnanden från andra som faktor.
Dokumenterat, rimligt eller okänt: signal för signal
Tabellen samlar läget för de fyra signalerna i frågan. Kategorin "rimligt antagande" betyder att slutsatsen följer logiskt av dokumentation eller forskning men inte har bekräftats för AI-svar specifikt.
| Signal | Dokumenterat | Rimligt antagande | Okänt |
|---|---|---|---|
| Länkar | Del av Googles och Bings rankning i vanlig sökning. | Påverkar vilka sidor som blir kandidater i AI-tjänster som bygger på dessa index. | Om länkar påverkar valet av citerad källa bland kandidaterna. |
| Omnämnanden utan länk | Ingen leverantör dokumenterar dem som signal. | Fler omnämnanden ökar chansen att en tredjepartssida om dig hämtas, och att modellen känner till varumärket från träningsdata. | Om omnämnanden används som direkt rankningsfaktor. |
| Avsändare och författare | Bing nämner transparent författarskap. Google beskriver frågan "vem skapade innehållet" i riktlinjerna för hjälpsamt innehåll. | Tydlig avsändare bidrar till trovärdighetsbedömningar i söksteget. | Om författarmärkning i schema påverkar AI-citeringar. |
| E-E-A-T | Ett ramverk i Googles riktlinjer, enligt Google inte en enskild rankningsfaktor. | Det som systemen belönar i Sök följer med till AI-funktioner som bygger på Sök. | Om andra leverantörer har motsvarande bedömning. |
Vilka slutsatser ska du inte dra?
Flera vanliga påståenden går längre än underlaget. De är värda att känna igen eftersom de leder till felprioriteringar.
- "AI-tjänster har en E-E-A-T-poäng." Varken Google eller någon annan leverantör beskriver en sådan poäng. Att lägga in författarnamn för att höja en tänkt poäng har inget dokumenterat stöd.
- "Schema för författare ger auktoritet." Strukturerad data hjälper maskiner att läsa vem som står bakom en text. Google har uttryckligen sagt att AI-funktionerna inte kräver någon särskild uppmärkning. Schema är ett sätt att göra befintlig information tydlig, inte en egen auktoritetskälla.
- "Köpta länkar ger fler AI-citeringar." Länkmanipulation bryter mot Googles spampolicyer, och det finns inga publicerade belägg för att det skulle fungera i AI-svar.
- "Korrelation är orsak." Analyser som visar att citerade sajter har många länkar kan förklaras av att samma sajter också har mer innehåll, äldre domäner och fler omnämnanden. Utan kontrollerade försök går det inte att isolera länkarnas effekt.
Vad kan du göra oavsett vad som visar sig stämma?
Vissa åtgärder är värdefulla under alla tre scenarierna: om auktoritetssignaler väger tungt, om de bara påverkar söksteget eller om de knappt spelar någon roll. Ordningen nedan går från det som är bäst dokumenterat till det som vilar mer på rimliga antaganden. Strategin för att bygga trovärdighet på längre sikt beskrivs i Digital auktoritet för GEO, och den upprepas inte här.
- Säkerställ åtkomst och indexering. Detta är det enda som samtliga leverantörer dokumenterar. Kontrollera att sökbotarna inte blockeras i robots.txt, att sidorna är indexerade i Google och Bing och att utdrag inte begränsas av misstag med nosnippet eller max-snippet.
- Skriv för relevans först. Forskningen från Wan med flera tyder på att relevans för frågan väger tyngst i modellsteget. Ge varje sida ett tydligt huvudsvar som en modell kan återge utan att tolka.
- Underbygg påståenden i texten. Namngivna källor, citat och siffror med ursprung gav effekt i GEO-studiens testmiljö och är dessutom god redaktionell praxis.
- Gör avsändaren tydlig och konsekvent. Ange organisation, författare och kontaktuppgifter synligt, och beskriv dem på samma sätt på sajten, i strukturerad data och i externa profiler. Detta stämmer med både Googles och Bings formuleringar om vem som står bakom innehållet.
- Bli omnämnd av andra av verkliga skäl. Egen data, verktyg, tydliga ställningstaganden och expertis som journalister och branschsajter vill hänvisa till ger både länkar och omnämnanden. Det gynnar dig i söksteget och gör att tredjepartssidor om dig kan hämtas.
- Mät i stället för att anta. Följ upp ett fast urval av frågor över tid och notera vilka källor som citeras, även konkurrenters och tredjeparters. Metoder beskrivs i Så mäter du GEO-resultat.
Exempel: en avsändarbeskrivning före och efter
Skillnaden mellan en otydlig och en tydlig avsändare handlar ofta om några meningar. Exemplet visar en artikelsignatur.
Före: "Skrivet av redaktionen."
Efter: "Skrivet av Anna Exempel, elsäkerhetsansvarig på Exempelbolaget AB sedan 2015. Granskat av Erik Exempel, behörig elinstallatör. Senast uppdaterad 10 november 2026."
Den andra versionen ger varken garanterad citering eller bättre rankning. Den gör däremot avsändare, erfarenhet och aktualitet läsbara för både människor och maskiner, vilket är det som Google och Bing beskriver i sina riktlinjer.
Hur kontrollerar du förutsättningarna på din egen sajt?
Åtkomst och avsändartydlighet går att granska systematiskt, medan extern auktoritet måste följas upp med andra metoder. Visicite kör bland annat E-E-A-T-kontroller av identifierbar avsändare, namngivna författare, externa källor och enhetskonsekvens, tillsammans med tekniska kontroller av AI-crawlerregler och snippet-begränsningar. Poängen mäter tekniska och redaktionella förutsättningar och förutsäger inte om sajten blir citerad. En regelbaserad gratis GEO-analys av en URL kräver inget konto.
Vanliga frågor
Är länkar viktiga för att bli citerad av AI?
Länkar är dokumenterade som rankningsfaktor i Googles och Bings vanliga sökning, och AI-funktioner hos Google och Microsoft bygger på dessa söksystem. Det är därför rimligt att länkar påverkar vilka sidor som blir kandidater. Om länkar påverkar själva valet av citerad källa är inte publicerat.
Påverkar E-E-A-T AI Overviews?
Google beskriver E-E-A-T som ett ramverk, inte en enskild rankningsfaktor, och anger att AI Overviews bygger på samma system som Sök. Det som systemen belönar i Sök följer därför sannolikt med, men någon separat E-E-A-T-bedömning för AI-svar finns inte dokumenterad.
Räknas omnämnanden utan länk?
Ingen leverantör dokumenterar omnämnanden utan länk som rankningssignal. Omnämnanden kan ändå påverka indirekt, eftersom sidor som nämner dig kan hämtas och citeras och eftersom varumärken som förekommer ofta finns med i modellernas träningsdata.
Bedömer språkmodellen själv om en källa är trovärdig?
Forskningen från Wan, Wallace och Klein (ACL 2024) tyder på att modeller främst går på relevans och i stort bortser från drag som vetenskapliga referenser och neutral ton. Trovärdighetsbedömningen sker därför sannolikt främst i söksteget, men det är inte dokumenterat för de kommersiella tjänsterna.
Hjälper författarschema för AI-citeringar?
Det finns inga publicerade belägg för att författarschema i sig ökar AI-citeringar, och Google kräver ingen särskild uppmärkning för AI-funktionerna. Schemat är användbart för att göra synlig avsändarinformation maskinläsbar och konsekvent.